它是什么
分布式锁让一次只有一个客户端有权去做某件事(运行夜间任务、写一个文件、担任 leader),而这些客户端分布在互不共享内存的机器上。难点不在于把锁发出去,而在于:当系统对”谁持有锁”出现分歧时,会出什么问题。锁分两种:效率锁(避免重复工作,偶尔重复发放无害)和正确性锁(重复发放会损坏数据)。两者的设计差别很大。
Important
核心要点: 安全性是分层的。共识让大家对谁持有锁达成一致;fencing token 挡住那个不知道自己已经丢了锁的过期持有者。锁服务本身无法让一个暂停的进程停止动作,所以没有 fencing 的正确性锁是不安全的。
何时需要它
凡是涉及单例任务、leader 选举或对共享资源的独占访问的设计,都会引出”如果持锁者崩溃了、或者暂停了怎么办?“这个问题。常见的陷阱是回答”用 Redis 加锁并设一个 TTL”,然后就停在那里。
Note
面试信号: 说出”TTL 只是对时钟的一种看法;资源端的 token 检查才是事实”,说明你理解了为什么超时无法解决过期持有者的问题。点明垃圾回收暂停就是那个具体的故障,是让回答落地的细节。
三种实现方式
| 维度 | 单个 Redis | Redlock(5 个 Redis 取多数) | 基于共识的 session(ZooKeeper、etcd、Chubby) |
|---|---|---|---|
| 节点故障切换时重复发放 | 会:异步复制可能丢掉这把锁 | 不会(多数派) | 不会(复制状态机) |
| 是否依赖时钟行为 | 只依赖 TTL | 依赖:安全性论证依赖时钟漂移有界且客户端没有暂停 | 心跳时序只影响活性,不影响安全性 |
| 暂停之后的过期持有者 | 没有防护 | 没有防护 | 没有 fencing 就没有防护 |
| 获取锁的延迟 | 约 1 ms | 5 次并行往返 | 一次共识提交,几毫秒 |
| 适用于 | 效率锁 | 很少的场景 | 正确性锁和 leader 选举 |
单个 Redis。 SET lock NX PX ttl,带一个唯一值,用 compare-and-delete 脚本释放。在一个健康的节点上是可靠的。漏洞在于:复制是异步的,所以主节点可能确认了加锁后就宕机,而副本还没看到;副本被提升为主后,下一个客户端又拿到了”同一把”锁。两个持有者,各自都有合法的授权。
Redlock。 在 5 个独立的 Redis 节点中获取多数,并用已耗时间对照 TTL。它消除了故障切换的漏洞,但依赖时钟漂移在界限之内、客户端在检查和使用之间没有暂停,而批评者攻击的正是这两点。
基于共识的 session。 锁状态存放在一个复制状态机(Raft 或 ZAB)里。客户端持有靠心跳维持的 session;锁是归属于某个 session 的**临时(ephemeral)**记录,session 过期时锁按一个统一的顺序被原子地删除。这种方式在分区期间是拒绝服务而不是重复发放,对正确性来说方向是对的。但要注意这个前提:它仍然拦不住过期持有者。
获取路径、session 与等待队列
- 客户端为每个进程(而不是每把锁)开一个 session,并发送
acquire("jobs/reindex")。 - leader 通过共识提交这条命令。状态机确定性地执行:如果锁空闲,就分配给该 session,并把这把锁的 fencing 计数器加一。
- 返回的授权是
{token: 34}。如果锁已被持有,请求会加入一个有序的等待队列,客户端设置一个 watch,不需要轮询。 - session 定期发送心跳(比如每 3 秒)。如果超过 session 超时(约 10 秒)没有心跳,状态机会让 session 过期,释放它的所有锁,并通知每个等待队列的队首。
为什么要有带顺序授权的等待队列:释放时只通知恰好一个等待者。另一种做法是通知所有人,让大家竞争重新获取,这会造成**惊群(thundering herd)**,在规模大时引发授权风暴。
Caution
常见错误: 把活性绑定在每把锁各自的 TTL 上,要求持有者不断续期。每把锁都变成一个独立的计时器,续期失败与业务工作互相竞争,一个持有 50 把锁的客户端要跑 50 个续期循环。session 把这件事反过来:一次心跳证明客户端还活着,客户端死亡的所有后果由状态机负责。
Fencing:正确性的另一半
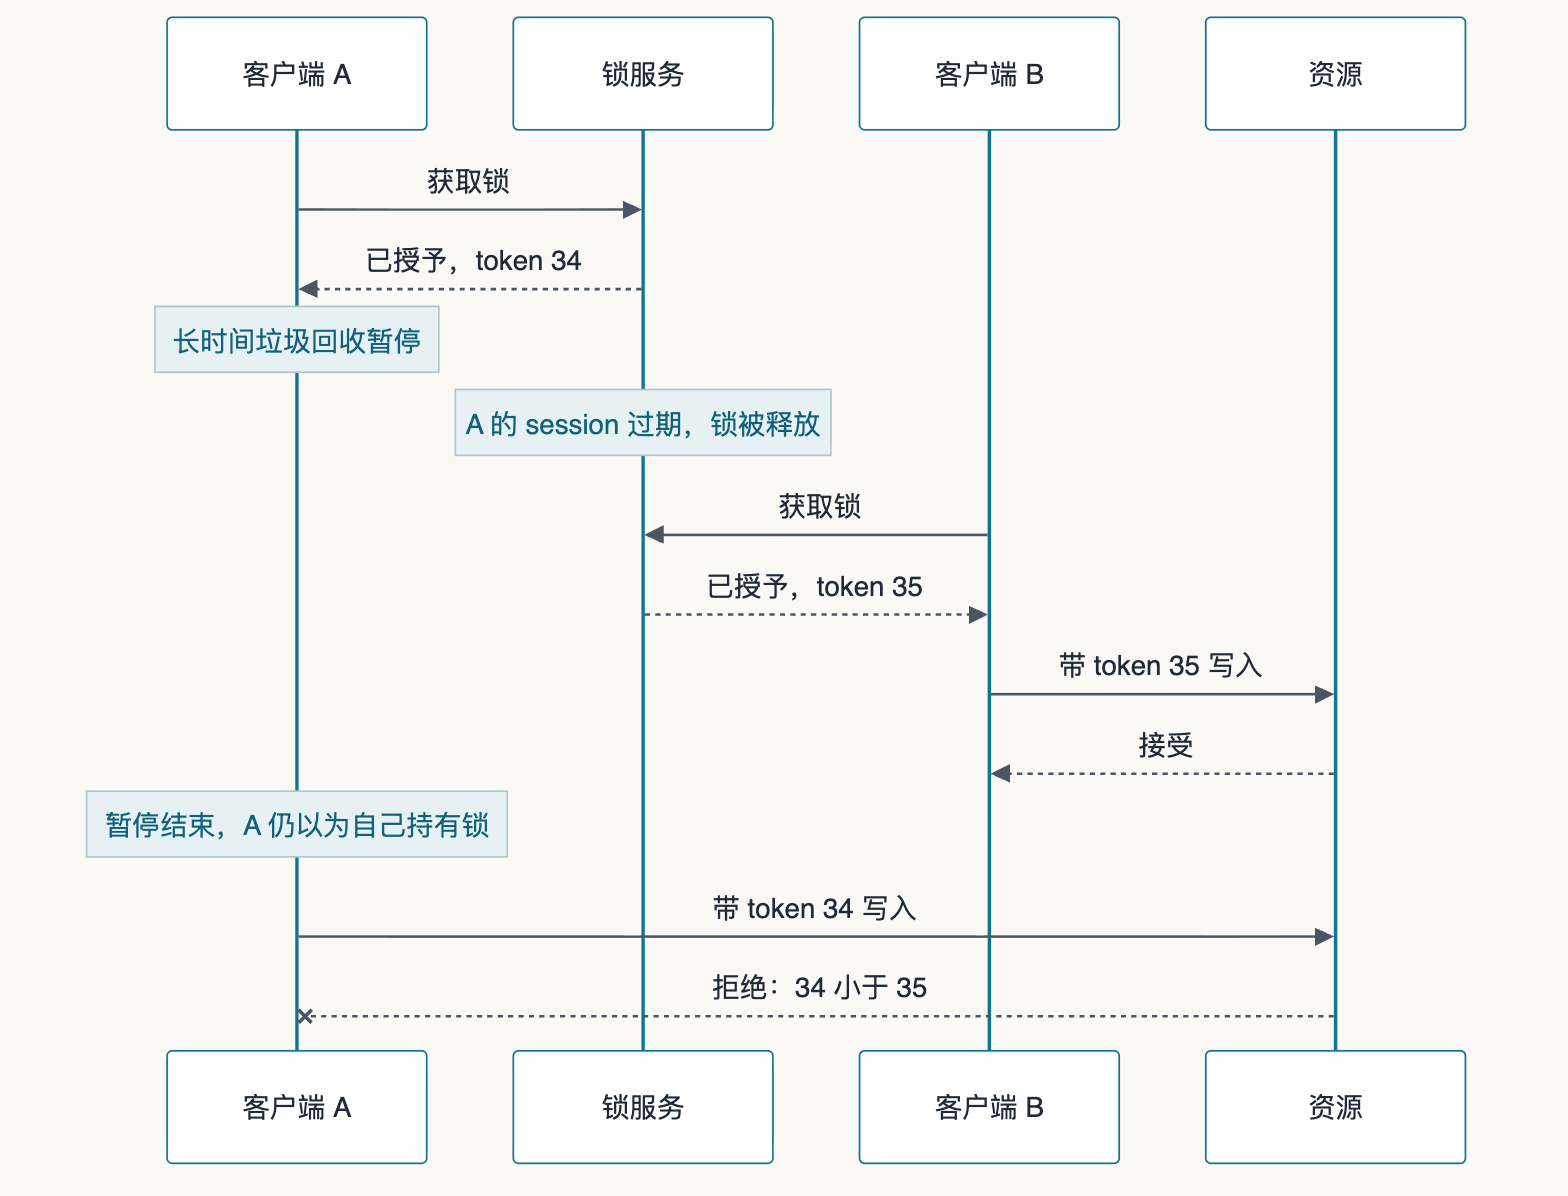
由资源端而不是锁服务来强制互斥:拒绝更小的 token。
时间线上的故障。
| 时间 | 事件 |
|---|---|
| t0 | A 获得锁,token 34,开始工作 |
| t1 | A 遇到一次 25 秒的 stop-the-world 垃圾回收暂停 |
| t2 | A 错过心跳;服务让它的 session 过期并释放锁 |
| t3 | B 获得锁,token 35,开始工作 |
| t4 | A 的暂停结束。A 仍然认为自己持有锁,并写入资源 |
没有 fencing,t4 就会损坏资源,而每个组件的行为都是正确的:服务让一个看起来已经死掉的 session 过期,A 只是慢了一点。调整超时无法解决这个问题;更长的超时只是用 t2 的及时性换来了更宽的 t4 窗口。
有了 fencing,每次对受保护资源的写入都带上这次授权的 token。资源记住自己见过的最大 token(B 的第一次写入记录了 35),并拒绝任何更小的。A 的写入带着 34 到达,被拒绝;A 只能以暂停的进程唯一可能的方式得知自己丢了锁:事后被告知。这个机制只是一次整数比较,却转移了保证的位置:互斥不再是锁服务对未来做出的承诺(“没有别人持有它”,在暂停面前无法知道),而是资源在当下做的一次检查(“这个 token 已经过期”,是一个事实)。
Warning
生产实践:
Fencing 要求资源配合:做一次带条件的写入来检查 token 的顺序,这在数据库里很简单(WHERE token <= 34),一些对象存储也通过前置条件原生支持。许多真实的资源什么也检查不了(第三方 API、SMTP 服务器)。对这些资源,没有任何分布式锁是安全的,老实的缓解办法是让操作幂等,并在事后对账。
用同一套机制做 Leader 选举
选举就是租期更长的获取路径:
- 每个候选者都尝试
acquire("election/orders-primary");赢家是 leader,输家 watch 并等待。 - fencing token 同时充当纪元号(epoch)。leader 在下游做的每个动作都带上它。
- leader 死亡就是 session 过期,然后队列里的下一个等待者以 epoch + 1 被提升。下游系统一旦见过 n + 1,就会拒绝 epoch n,所以两个自认为是 leader 的节点短暂重叠(脑裂)是可以容忍的:旧 leader 的动作会被弹回。
面试官常追问的一个细节:失去与锁服务联系的 leader 必须在它的 session 过期之前停止动作,按它自己的时钟,在 session 超时 - 安全余量 时退位。这个余量是唯一合理保留的时钟假设,而且它宁可偏向不可用(短暂没有 leader),也不偏向不安全(出现两个 leader)。
如何选择
| 情形 | 选择 | 原因 |
|---|---|---|
| 避免重复工作;偶尔重复运行一次无害 | 带 TTL 的单个 Redis 锁 | 简单快速 |
| 正确性重要(金钱、共享状态) | 基于共识的 session 加 fencing token | 达成一致,再加上对过期持有者的防御 |
| 服务的 leader 选举 | 共识锁;token 就是 epoch | 同一套机制,租期更长 |
| 资源无法检查 token | 重新设计:幂等操作,或避免使用锁 | 没有任何办法能让它安全 |
| 同一把锁有很多等待者 | 带 watch 的有序等待队列 | 避免惊群 |
相关
- 演练:设计分布式锁 — 完整的锁服务设计,包括 session 和等待队列。
- 演练:设计分布式任务调度器 — 用租约和 fencing 做到每个任务至多一个活跃执行。
- 参考:共识与 Leader 选举 — 正确性锁底下的那一层一致性。