它是什么
共识(consensus) 是一组机器在一些机器崩溃、消息被延迟的情况下,仍然对一个值(或一个有序的值日志)达成一致的方式。它是锁服务、元数据存储,以及承诺零数据丢失的数据库的基础。Raft 是需要了解的共识算法:它保存一份复制的日志,选出一个 leader 来为每次写入排序,并在多数派存下一个条目后才提交它。
Important
核心要点: 共识买到的是能在故障中存活的一致,代价是:每次写入都要等待多数派,所以吞吐被限制在一个 leader 上,延迟包含到第二近的副本的一次往返。把它用在小而关键的核心上(谁是 leader、谁持有锁、提交决定),把大块数据放在更便宜的复制上。
何时需要它
“副本怎么就谁是 leader 达成一致?“以及”为什么是三个或五个节点,而不是四个?“,在任何需要强一致核心的设计里都会出现:锁、配置、协调者,或一个 CP 数据库。
Note
面试信号: 你不需要推导 Raft。能说出”一份有 leader 的复制日志、多数派提交、leader 沉默时重新选举”,并给出 quorum 的算术,就是期望的深度。知道它是 CP 的(少数派分区会拒绝写入)是资深的加分项。
保证与算术
一个由 n = 2f + 1 个节点组成的集群可以容忍 f 个故障,因为多数派(f + 1)仍然存活,而且任意两个多数派至少有一个共同节点。
| 节点数 | 需要的多数派 | 可容忍的故障数 |
|---|---|---|
| 3 | 2 | 1 |
| 4 | 3 | 1(不比 3 更好) |
| 5 | 3 | 2 |
| 7 | 4 | 3 |
这就是为什么集群使用奇数规模:第四个节点增加了成本和更大的 quorum,却并没有多容忍一个故障。更大的集群能容忍更多故障,但会让每次写入等待更多的确认,所以三个或五个是典型的。
Raft 是怎么工作的
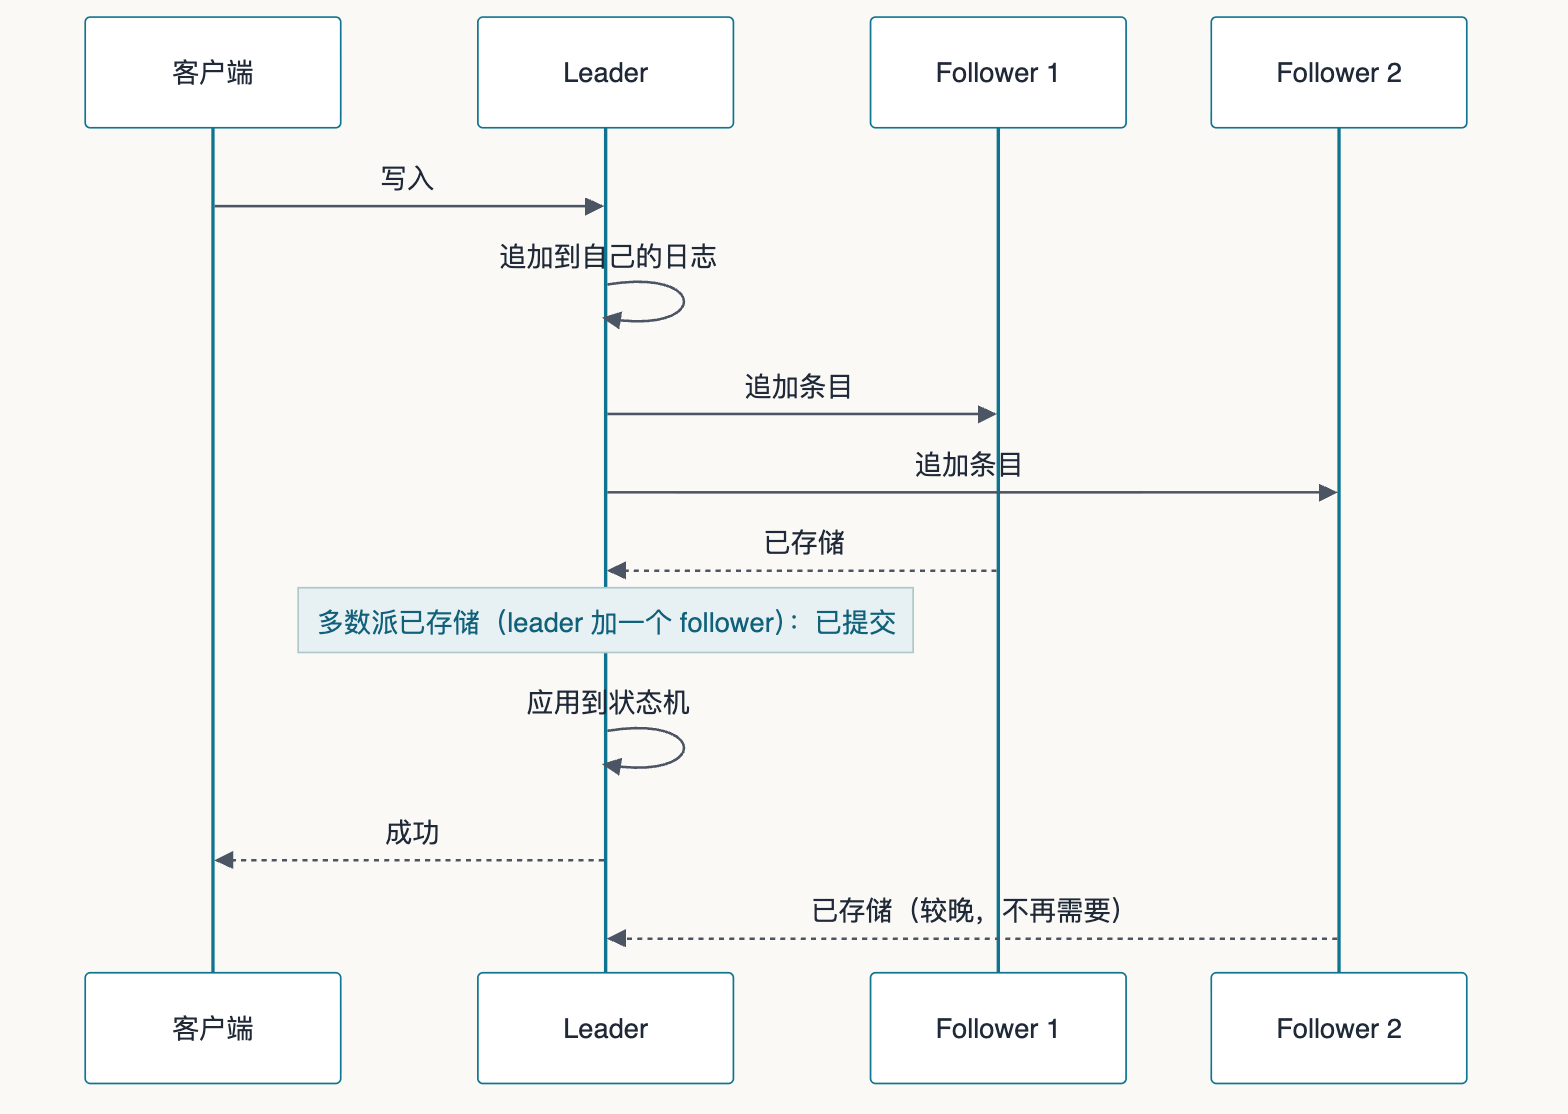
当多数派(包括 leader)拥有它时,一次写入就提交了。
角色与任期。 每个节点是 follower、candidate 或 leader 之一。时间被划分为编号的任期(term);每个任期至多有一个 leader。
Leader 选举。
- leader 定期发送心跳。一个在随机化的选举超时(典型范围是 150 到 300 ms)内什么也没听到的 follower,会变成 candidate、把任期加一,并向其他节点请求投票。
- 一个节点在每个任期只投一票,并且只投给日志至少与自己一样新的 candidate。这条规则保证任何当选的 leader 都已经持有每一个已提交的条目。
- 得到多数派投票的 candidate 成为 leader。随机化的超时让平票很少见,并能很快解决。
日志复制。
- 所有写入都发给 leader,它把条目追加到自己的日志并发给 follower。
- 当多数派(算上 leader)存下了条目,它就已提交:leader 把它应用到自己的状态机,并回复客户端。
- follower 在之后的消息里得知 commit index,也应用该条目。每个节点以相同的顺序应用相同的条目,所以每个状态机最终都是一样的。
算例。 在一个五节点的集群里,一次写入需要 leader 加两个 follower:五个里的三个。leader 的延迟是到它第二快的 follower 的往返时间,所以一个慢的或死掉的节点不会拖慢提交。如果 leader 死了,follower 的选举超时会过期(在几百毫秒内),其中一个赢得多数票,写入随之恢复。少数派分区(比如两个节点)无法选出 leader,并会拒绝写入,这就是 CP 的行为。
读。 朴素地从 follower 读可能是过期的。要做 linearizable 的读,读请求要经过 leader,由它先确认自己仍然是 leader(通过一轮心跳或 leader lease)再应答。从 replica 读很快,但可能落后。
把 Leader 选举当作构件
服务使用共识存储(ZooKeeper、etcd、Consul)来选举它们自己的 leader:candidate 竞争去创建一个临时记录或获取一把锁,赢家就是 leader,而它的 epoch(一个 fencing token)伴随它的每个动作,所以被废黜的 leader 会在下游被拒绝。共识集群保持小而关键;它所协调的服务可以很大。
每个 shard 一个共识组
需要同时兼顾规模和零数据丢失的数据库,会让每个 shard(range)运行一个共识组:每个 range 有自己的 leader 和几个 replica,所以对不同 range 的写入可以并行进行。跨 range 的事务会在其上叠加一个提交协议。代价是每次写入的共识延迟。
Warning
生产实践: 共识集群对时序很敏感。被一次长时间垃圾回收暂停或慢磁盘拖住的 leader 看起来像是死了,会触发一次选举;过载的网络会引起选举风暴。要根据环境调整超时,保持集群小、用快磁盘,并把它和有噪声的工作负载分开运行。
Raft、Paxos 与 ZAB
三者解决的是同一个问题。Paxos 是最早的,出了名地难以实现和解释;Raft 为了易懂而设计,保证相同,是常见的选择(etcd、Consul、许多数据库);ZAB 驱动 ZooKeeper,采用类似的基于 leader 的设计。在面试里,说”Raft 风格”就够了。
如何选择
| 需求 | 选择 | 原因 |
|---|---|---|
| 就一个小而关键的值(leader、锁、配置)达成一致 | 共识存储(etcd、ZooKeeper) | Linearizable,能容忍 f 个故障 |
| 数据库要零数据丢失和自动 failover | 每个 shard 一个共识组 | 一份有选出的 leader 的复制日志 |
| 可用性优先于一致性,能容忍冲突 | Leaderless quorum(不是共识) | 没有 leader 可等 |
| 大块数据的高写入吞吐 | 不要让每次写入都走共识 | 一个 leader 是吞吐的天花板 |
| 强读 | 通过 leader 读(或 lease) | follower 可能落后 |
Caution
常见错误: 把大流量数据放进共识集群。每次写入都由一个 leader 排序并等待多数派,它是为小规模的控制面设计的,不是数据面。把数据存放在别处,只把协调留在共识里。
相关
- 演练:设计分布式锁 — 构建在共识核心之上的锁服务。
- 演练:设计分布式数据库 — 每个 range 一个共识组,让零数据丢失也能扩展。
- 参考:分布式锁与 Fencing Token — 为什么对 leader 达成一致之后,下游仍然需要 fencing。