它是什么
存储引擎是单节点上把 get 和 put 变成磁盘操作的组件:一次写入如何变得持久、如何找到一个 key、空间如何回收。三种设计几乎涵盖了你在面试中会提到的所有数据库。B-tree 原地更新页;LSM-tree 追加写入并在后台合并;Bitcask 追加到日志,并把所有 key 保存在内存的 hash 索引里。
Important
核心要点: 引擎决定了读/写放大的取舍,选错了,无论分布式层设计得多好,你的 p99 都会被它封顶。以追加为主的写入(事件、指标、带版本的记录)适合 LSM-tree;读多、需要范围扫描的 OLTP 适合 B-tree;key 集合能放进内存、只做点读的场景适合 Bitcask。
何时需要它
任何”选哪个数据库”的回答,最终都会碰到”它底下的存储引擎是什么?“,而追问”为什么这条写路径很快?“就在这里回答。大多数面试里,说出引擎名并用一句话解释它为什么匹配写模式就够了。只有面试官追问时,才深入 compaction 策略和 bloom filter 的数学。
Note
面试信号: “LSM,因为每次写入都是一条新的带版本记录,所以写路径是顺序追加,成本转移到了后台 compaction”,这就是一句话的答案。同一口气说出读侧的代价(读放大,由 bloom filter 缓解),才让它显得资深。
三种引擎
| 引擎 | 写模型 | 读模型 | 适合 | 注意 |
|---|---|---|---|---|
| LSM-tree(RocksDB、Cassandra、LevelDB) | 追加到日志和内存表;刷成不可变的有序文件;后台合并 | 点读先查内存表,再对每个文件查 bloom filter 和索引 | 写多的负载、大数据集、可压缩的值 | 读放大(一次读涉及多个文件);compaction 的 I/O 与前台流量争抢 |
| B-tree(InnoDB、PostgreSQL) | 原地更新页;用 write-ahead log 保证持久 | O(log n) 遍历;范围扫描出色 | 读多、范围查询、OLTP | 随机原地更新带来的写放大;高写入下的页拆分和碎片 |
| Bitcask(Riak 默认) | 追加到日志;内存 hash 把每个 key 映射到它在磁盘上的偏移 | 一次磁盘寻道:hash 查找,然后按偏移读取 | 能放进 RAM 的 key 集合;最快的点读 | 所有 key 必须放进内存;没有范围查询;需要 merge 才能回收空间 |
Write-ahead log
B-tree 和 LSM-tree 都会在一切之前放一层 write-ahead log(WAL)。一次写入先被追加到日志(顺序写,强制落盘),然后才应用到内存中的结构。如果进程崩溃,就重放日志来重建只存在于内存中的内容。这就是为什么数据库可以在还没更新主数据结构时就确认一次写入。
持久性的旋钮是日志何时被强制落盘:每次写入都落(最安全、最慢)、小批量地落(group commit,常见的折中,许多写入共用一次 flush),或者周期性地落(快,但有一个可能丢数据的窗口)。声称”持久”时,要说出你选的是哪一种。
LSM-tree 是怎么工作的
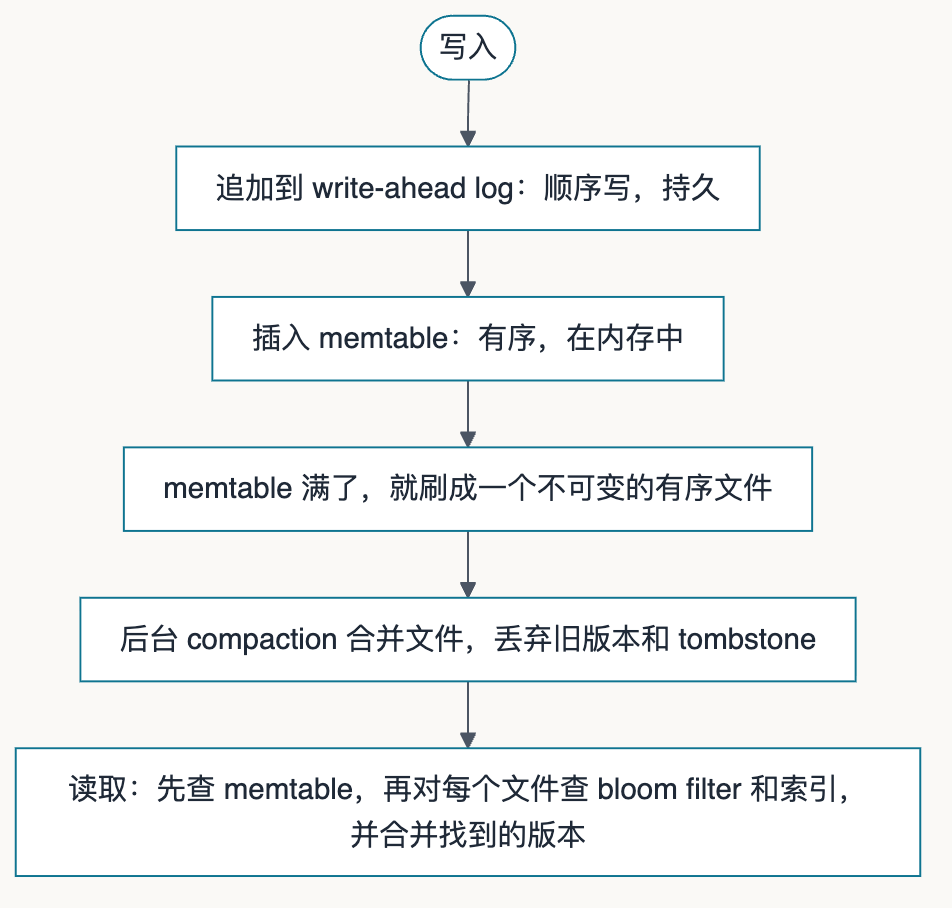
写入是顺序追加。读取为此付出代价:要在不止一个地方查找。
- 写入。 追加到 WAL;插入 memtable(内存中的有序结构)。
- 刷新(flush)。 memtable 满了,就写成顶层的一个不可变有序文件(SSTable)。顺序写,很快。
- Compaction。 后台任务合并文件,丢弃被覆盖的版本和已删除的 key(tombstone),并让文件数量保持较少。
- 读取。 查 memtable;然后对每个文件,问它的 bloom filter 这个 key 是否可能在那里,只有答案是”可能”时才读该文件的索引和数据块。合并找到的版本,返回最新的。
Compaction 是维护成本,主要有两种策略:
| 策略 | 做法 | 取舍 |
|---|---|---|
| Leveled(RocksDB 默认) | 每一层有大小上限;同一层内的文件覆盖互不相交的 key 范围 | 读更好(一个 key 在每层至多出现在一个文件里);写放大更高 |
| Size-tiered(Cassandra 默认) | 把大小相近的文件合并在一起 | 写吞吐更好;读更差(一个 key 可能出现在多个文件里) |
实用的规则:读多用 leveled,写多用 size-tiered。 一个读写比约 3:1 的引擎处在中间,所以通常选 leveled,并给 compaction 留足 I/O 预算。
算例:为什么 bloom filter 值得。 对一个不存在的 key 做点读,否则要探测每一个文件。假设有 5 个候选文件,bloom filter 约每个 key 10 bit(大约 1% 的假阳性率,没有假阴性),那么不必要的文件读取的期望数量从 5 降到 5 × 0.01 = 0.05。在每秒一百万次读时,这就是磁盘被打满与几乎不碰磁盘的区别,这也是 bloom filter 成为 LSM-tree 标准读优化的原因。代价是内存(每个文件每个 key 约 10 bit)和少量的假阳性。
Warning
生产实践: Compaction 是 LSM 引擎最容易受伤的地方。一阵写入突发可能让文件堆积的速度超过 compaction 合并的速度;读变慢(每次读要查更多文件),最终引擎会限制写入来追赶。要盯住 compaction 积压和每层的文件数,并给 compaction 单独的 I/O 预算,不要让它和前台流量抢资源。
如何选择
| 工作负载 | 引擎 | 原因 |
|---|---|---|
| 写多的摄入(时序、事件、日志、指标) | LSM-tree | 顺序追加;成本移到后台 |
| 带版本或只追加的记录混合场景 | LSM-tree | 覆盖和删除都只是新记录;compaction 会把它们折叠 |
| 读多的 OLTP、范围扫描、延迟可预测 | B-tree | 一次遍历,不需要跨多个文件合并 |
| 数十亿个能放进 RAM 的小 key,只做点读 | Bitcask | 每次读一次寻道,吞吐无可匹敌 |
| 很多二级索引 | 两者都要小心 | 每个索引都会放大写放大 |
Bitcask 的限制是算术上的:每个 key 的索引条目约 64 字节,所以 10 亿个 key 大约需要 64 GB 内存,1,000 亿个 key 大约需要 6.4 TB,这就是它只适合 key 集合小的场景的原因。
Caution
常见错误: 说 LSM-tree “更快”却不提读侧的代价,或者说 B-tree “更慢”却不提工作负载。引擎只是在读和写之间转移成本,两者都不会消除它。要根据你的工作负载主要被哪一侧主导来选择。
相关
- 演练:设计分布式数据库 — 叠加在引擎选择之上的分布式层。
- 演练:设计分布式 KV 存储 — 一个以追加为主的存储,LSM-tree 的写路径正好匹配。
- 参考:数据库索引 — 从查询侧看 B-tree 与 LSM-tree:哪种索引服务哪种访问模式。